
Elke week komt er een model langs dat belooft iets beter of goedkoper te doen dan wat er al draait. Deze week was dat Jev AI, en de vraag kwam van een klant: kan dit iets toevoegen aan de assistent die ik voor zijn webshop in mannenverzorging bouw? Die assistent helpt een bezoeker die zijn probleem kent maar zijn product niet. Vet haar, pluizig haar om twee uur ’s middags, een baard die jeukt.
Ik heb de vraag beantwoord zonder een regel code te schrijven, en dat was bewust. Drie vragen vooraf beslissen of een meting zin heeft, en voor deze assistent viel het op alle drie af. Hieronder de vragen, het antwoord per vraag, en het profiel waar zo’n model wel thuishoort.
Wat Jev AI is
Jev is een model van TypeSafe dat geen tekst schrijft. Je geeft het een tekst en een vraag met een vaste vorm: ja of nee, een keuze uit opties die je zelf opgeeft, of een score op een schaal. Terug komt een kans, bijvoorbeeld 96 procent ja, met een betrouwbaarheid erbij. Het beantwoordt meerdere vragen tegelijk over dezelfde tekst, tot 32.000 tokens invoer per aanroep, in ongeveer een halve seconde.
De toepassingen die de makers zelf noemen: supporttickets sorteren, een vraag naar het juiste team of model sturen, reviews scoren, leads kwalificeren, en de tekstfragmenten beoordelen die een zoekstap ophaalt voordat een taalmodel ermee aan de slag gaat. De jaarpakketten lopen van 174 tot 588 dollar, alleen de invoer telt en de uitvoer is gratis. Vijf gratis tegoeden om te proberen. En een zin in de documentatie die voor een Nederlandse webshop zwaar weegt: het model werkt het best in het Engels, in andere talen met minder nauwkeurigheid.
Hoe ik het heb beoordeeld
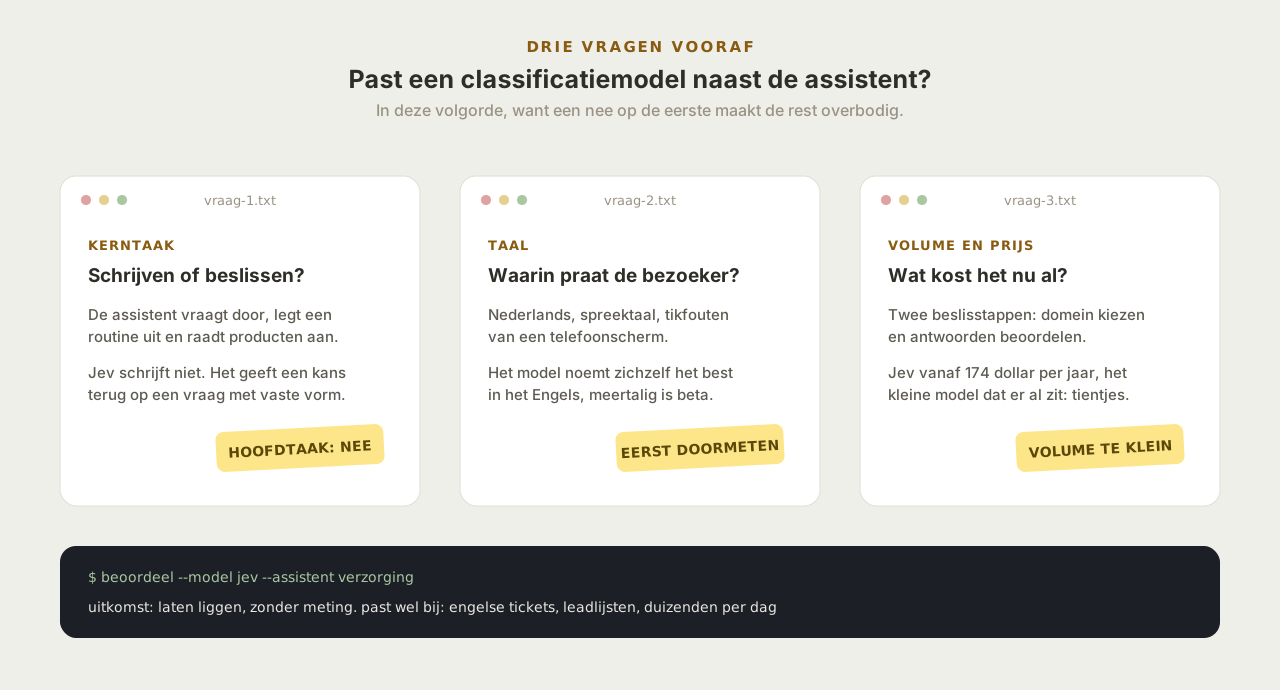
Een nieuw model doormeten kost een dag, en de uitkomst is alleen bruikbaar als de vraag eronder klopt. Daarom eerst drie vragen op papier, in deze volgorde, omdat een nee op de eerste de andere twee overbodig maakt.
- Is de kerntaak schrijven of beslissen? Een model dat kansen geeft kan geen gesprek voeren. Het kan wel de stappen naast het gesprek doen die een keuze zijn.
- In welke taal praten de gebruikers? Een model dat zichzelf het best noemt in het Engels moet je eerst in het Nederlands doormeten, en die meting hoort in de rekensom.
- Hoeveel volume gaat erdoorheen, en wat kost dezelfde stap met wat er al draait? Een nieuw model is zelden de enige manier om een stap te doen. Meestal kan het kleine taalmodel dat er al in zit dezelfde beslissing nemen, en dan telt het prijsverschil alleen bij groot volume.
De derde vraag wordt het vaakst overgeslagen, omdat de prijs per aanroep zo laag oogt. Maar je vergelijkt niet met nul, je vergelijkt met wat de stap nu kost.
Vraag 1: de assistent moet praten
De kern van de assistent is een gesprek. Hij vraagt door, legt een routine uit en raadt daarna producten aan uit een catalogus van 1.416 artikelen. Dat is schrijfwerk, en Jev schrijft niet. Daarmee valt het af voor de hoofdtaak, en dat is het eerste eerlijke antwoord aan de klant.
Er zitten wel twee stappen naast het gesprek die een beslissing zijn. De assistent bepaalt bij elk bericht over welk verzorgingsdomein het gaat, haar, baard, gezicht of lichaam, en stuurt alleen de catalogus van dat domein mee. Dat scheelt veel: de hele catalogus is 230.000 tekens, een domein is 40.000 tot 60.000. Nu doet een woordenlijst dat werk. De tweede stap is de kwaliteitscontrole: de 145 vragen en antwoorden in de kennisbank en de antwoorden van de assistent zelf worden door een tweede taalmodel beoordeeld op juistheid en klanttaal. Allebei precies het soort vraag dat Jev beantwoordt, een keuze uit vier en een score op een schaal. Dus door naar vraag twee.
Vraag 2: de bezoekers praten Nederlands
Hier wordt het smal. “Mijn haar is om twee uur al vet” moet in het Nederlands begrepen worden, met de spreektaal en de tikfouten die bij een telefoonscherm horen. Voor de domeinkeuze is een misser goedkoop, de assistent krijgt dan de verkeerde catalogus mee en herstelt zich een bericht later. Voor de kwaliteitscontrole is een misser duur, want daar bepaalt de score of een antwoord de kennisbank in gaat.
Er is een zustermodel voor meerdere talen, maar dat draagt nog het label beta. Een meting zou dus bij twee modellen tegelijk moeten beginnen, elk op een paar honderd Nederlandse berichten met een handmatig label. Dat is geen bezwaar op zich, het maakt alleen de derde vraag beslissend: is die meting het waard bij dit volume?
Vraag 3: het volume is te klein voor het prijsverschil
| Stap | Nu | Met Jev | Wat het scheelt |
|---|---|---|---|
| Gesprek voeren | taalmodel | kan niet | niets |
| Domein kiezen | woordenlijst | keuze uit vier, een aanroep per bericht | betere keuze bij twijfelgevallen, geen kostenverschil |
| Antwoorden beoordelen | taalmodel als beoordelaar | score per antwoord | lagere prijs per aanroep, andere taal |
Het goedkoopste jaarpakket is 174 dollar. De assistent draait op een gespreksvolume waarbij dezelfde twee stappen met het kleine taalmodel dat er al in zit naar schatting enkele tientallen euro’s per jaar kosten. Het verschil per aanroep is echt, het verschil per jaar is niet te zien. Daar staat tegenover wat elk extra model kost zonder dat het op een factuur staat: een extra leverancier, een extra sleutel om te beheren, en een taalrisico dat je eerst moet wegmeten.
Het antwoord is dus nee, en het is een nee zonder meting. In dit geval is dat de juiste zuinigheid: de meting zou een dag kosten om een verschil van tientallen euro’s per jaar te bevestigen.
Waar het wel past
Draai de drie vragen om en je hebt het profiel waar Jev thuishoort: de kerntaak is een beslissing, de teksten zijn Engels, en er gaan er duizenden per dag doorheen. Een supportinbox die naar het juiste team moet, leadlijsten die gescoord worden op een profiel, of de controle van opgehaalde tekstfragmenten voordat een taalmodel ze gebruikt. Daar werkt een model dat kansen geeft zelfs in je voordeel, want een kans van 62 procent kun je een drempel geven en een zin niet.
Voor wie dit nu speelt
Heb je een assistent of chatbot op je site, dan krijg je elke maand iets nieuws aangereikt. Stel de drie vragen in deze volgorde en meet pas als alle drie een ja opleveren. De eerste stap kost een half uur: schrijf op welke stappen in je assistent een beslissing zijn en welke schrijfwerk. Meestal zijn dat er twee of drie, en die lijst is meer waard dan het volgende model.
Hoe zo’n assistent van binnen zit staat in zo werkt het geheugen van een AI-agent, en hoe een gesprek een webshop in kan reizen in de contextlaag van de NeverLeafs-keuzehulp.