
Bij de webshops die ik begeleid sturen we op rendementsdoelen. Doel-ROAS per campagne, POAS als de marge per product uiteenloopt, budget per productgroep. Dat werkt, tot iemand vraagt wat er gebeurt als een artikel van 24,95 naar 26,45 gaat. Dan is het antwoord een onderbuikgevoel, terwijl de prijs precies de knop is die zowel het volume als de marge raakt.
Prijselasticiteit is het getal dat die vraag beantwoordt: bij -1,5 kost 1 procent prijsverhoging ongeveer 1,5 procent volume. Het schatten ervan uit historische verkopen is een oud probleem met een bekende valkuil, namelijk dat prijs zelden willekeurig varieert. Je verlaagt hem juist als het slecht loopt, of als het seizoen aantrekt, en dan schrijft een naief model die beweging toe aan de prijs.
Er is sinds kort een Python-pakket dat dit met PyMC doet: pypricing. Bayesiaans, per SKU een eigen elasticiteit met een onzekerheidsband, hierarchisch zodat artikelen met weinig historie naar hun groep trekken, optioneel kruiselasticiteit tussen producten. Op papier precies wat ik zou willen.
Hoe ik het heb getoetst
Een geschatte elasticiteit ziet er altijd overtuigend uit. Er staat een getal, er staat een band omheen, en er is niets in je eigen data waaraan je kunt aflezen of het klopt. Dat is het lastige aan deze hele categorie modellen: de werkelijke prijsgevoeligheid van een artikel staat nergens opgeschreven, dus je kunt het antwoord niet nakijken. Je kunt alleen kijken of het model je verkopen goed voorspelt, en dat is een andere vraag.
Daarom heb ik het paneel zelf opgebouwd, met elasticiteiten die ik van tevoren vastlegde. 12 artikelen, 104 weken, drie categorieen, 1.248 regels. Het model krijgt alleen de kolommen die een webshop ook zou aanleveren en weet niets van die waarden. Achteraf kan ik per artikel nakijken of de opgegeven band de werkelijke elasticiteit omvat. Dat is de enige manier om te zien of zo’n band betekent wat hij beweert.
Wat het pakket doet
De invoer is een lang paneel: per regel een artikelnummer, een prijs en een verkocht aantal. Optioneel een period voor tijdbewuste evaluatie, een region, kolommen met het voorvoegsel control_ voor gedeelde regressoren, en groepskolommen voor de hierarchie.
Er zijn drie vraagmodellen. LogLogDemandModel is de standaard en gaat uit van een constante elasticiteit over het hele prijsbereik. QuadraticLogDemandModel laat de elasticiteit van de prijs zelf afhangen, zodat hij bij een hoge prijs anders kan zijn dan bij een lage. SigmoidSaturationDemandModel modelleert verzadiging met een geleerd prijscentrum per artikel.
Daarnaast zitten er fit_train_test voor evaluatie op de laatste periodes, optimize_prices voor een optimum binnen bandbreedtes, en run_diagnostics voor de sampler-diagnostiek in.
De versiepin die je nodig hebt
De metadata van het pakket kent alleen ondergrenzen: pymc>=5.0 en pymc-marketing>=0.19.0. Een verse install pakt dus de nieuwste van allebei, en die combinatie draait niet. Er lopen drie dingen vast, elk in een andere laag van de keten.
Het voorbeeld uit de eigen documentatie komt niet verder dan de eerste fit:
ValueError: Variable name 'obs' conflicts with an existing dimension name.PyMC 6 laat een variabele en een dimensie niet meer dezelfde naam delen, en in pypricing/models/log_log.py heten ze allebei obs. Pin je PyMC onder 6, dan verwacht pymc-extras juist wel versie 6:
ImportError: cannot import name 'resolve_backend_compile_kwargs' from 'pymc.pytensorf'En de versie van pymc-marketing die bij PyMC 5 hoort werkt niet samen met een moderne pydantic:
pydantic_core._pydantic_core.SchemaError: 'cls' must be valid as the first argument to 'isinstance'De combinatie die wel draait, op Python 3.12:
pypricing 0.0.1
pymc 5.28.5
pymc-marketing 0.19.4
pymc-extras 0.10.0
pytensor 2.38.2
arviz 0.23.4
pydantic 2.11.10
pandas 2.3.3
numpy 2.2.6
Dat is geen verwijt aan een 0.0.1, het hoort bij een jonge keten. Het is wel de reden om bij elke meting de hele set vast te pinnen en die pin erbij te publiceren. Zonder pin verloopt je conclusie stil, en leest iemand over een half jaar een uitkomst die op andere versies niet meer reproduceert.
Het paneel
Naast de drie kolommen die een webshop altijd heeft, zit er een controlevariabele in het paneel. De prijsvariatie loopt per artikel flink uiteen: uitgedrukt als standaarddeviatie van de logprijs gaat het van 0,068 voor het rustigste artikel tot 0,285 voor het meest bewegende. Dat getal bepaalt of er uberhaupt iets te schatten valt, want zonder prijsvariatie is er geen signaal.
model = LogLogDemandModel(
    panel_columns=PanelColumns(
        control_columns=("control_1",),
        group_columns=("category",),
    )
)
model.fit(df, draws=1000, tune=2000, chains=4, target_accept=0.95)
Meteen bij het bouwen kwam er een waarschuwing die ik precies goed vind:
UserWarning: 2 SKU(s) have quantity at/below quantity_floor for >= 50% of
their observations (['sku_10', 'sku_12']); elasticity for these SKUs is
likely unidentified from this data.
Die vloer zit erin omdat het model op logaritmes werkt en nul verkopen geen logaritme hebben. Standaard worden die op 1 gezet. Ligt een artikel daar structureel op, dan schat je op een verzonnen getal. Het pakket zegt dat zelf, met de exacte fractie in run_diagnostics(). Voor die twee artikelen stond die op 1,0, dus alle waarnemingen.
De sampler-instelling die in geen enkel voorbeeld staat
Met de standaardinstellingen uit de documentatie loopt de sampler slecht op dit paneel: 473 divergenties na het tunen, alle vier de ketens tegen de maximale boomdiepte aan. Met target_accept=0.95 en 2.000 tune-stappen zakt dat naar 17 divergenties en staat r-hat overal op 1,0. Dat is de instelling waarmee je hier moet draaien, en hij komt in de voorbeelden nergens voor.
De schattingen bewegen er nauwelijks van. Voor sku_1 gaat het gemiddelde van -1,321 naar -1,316 en blijft de band vrijwel gelijk. De sampler is dus niet waar het misgaat, hij gaf alleen het eerste teken dat er iets anders speelde.
De controle die iedereen aanraadt keurt het verkeerde goed
Het pakket heeft fit_train_test, dat de laatste periodes achterhoudt in plaats van een willekeurige steekproef te trekken. Dat is de juiste vorm: bij een willekeurige splitsing zit week 40 in je testset terwijl week 39 en 41 in de training zitten, en heeft het model de omgeving van dat punt al gezien.
Op de laatste 20 procent van de periodes, 252 van de 1.248 regels:
rmse: 9.34
hdi_coverage: 0.921
n_train: 996
n_test: 252
Die dekking van 0,921 tegen een nominale 0,90 is netjes. Het model voorspelt de verkopen in weken die het nooit heeft gezien, en het geeft daar een band bij die ongeveer klopt. Wie hier stopt concludeert dat het model deugt.
Dan de controle waarvoor ik het paneel zo had opgezet: de geschatte elasticiteit naast de werkelijke leggen. Daar valt het uit elkaar. Van de twaalf 90 procent-intervallen bevatten er drie de echte waarde. Voor sku_5 gaf het model -0,124 met een band van -0,229 tot -0,011, terwijl de werkelijke waarde -0,408 was. Een factor drie ernaast, met een smalle band eromheen en geen enkel signaal in de gewone diagnostiek.
Een model kan de verkopen van volgende maand goed voorspellen en tegelijk de verkeerde prijsgevoeligheid rapporteren. Bij een prijsbesluit is die parameter het product, niet de voorspelling.
Dat is het punt waar dit soort modellen in de praktijk misgaat. De standaardcontrole valideert de voorspelling, en de voorspelling kan kloppen terwijl de coefficient waar je op gaat handelen systematisch verschoven is.
De oorzaak: seizoen in de vraag, niet in het model
In het paneel zat een seizoenspatroon in de vraag. De enige controlevariabele die het model kreeg was een losse regressor die daar niets mee te maken had. Het seizoen moest dus ergens heen, en het beste beschikbare aanknopingspunt was de prijs, die immers meebeweegt met acties en met het jaarritme.
Om dat te toetsen heb ik hetzelfde paneel opnieuw opgebouwd, met exact dezelfde toevalskiem en dezelfde werkelijke elasticiteiten, maar zonder seizoen in de vraag. Verder veranderde er niets aan het model.
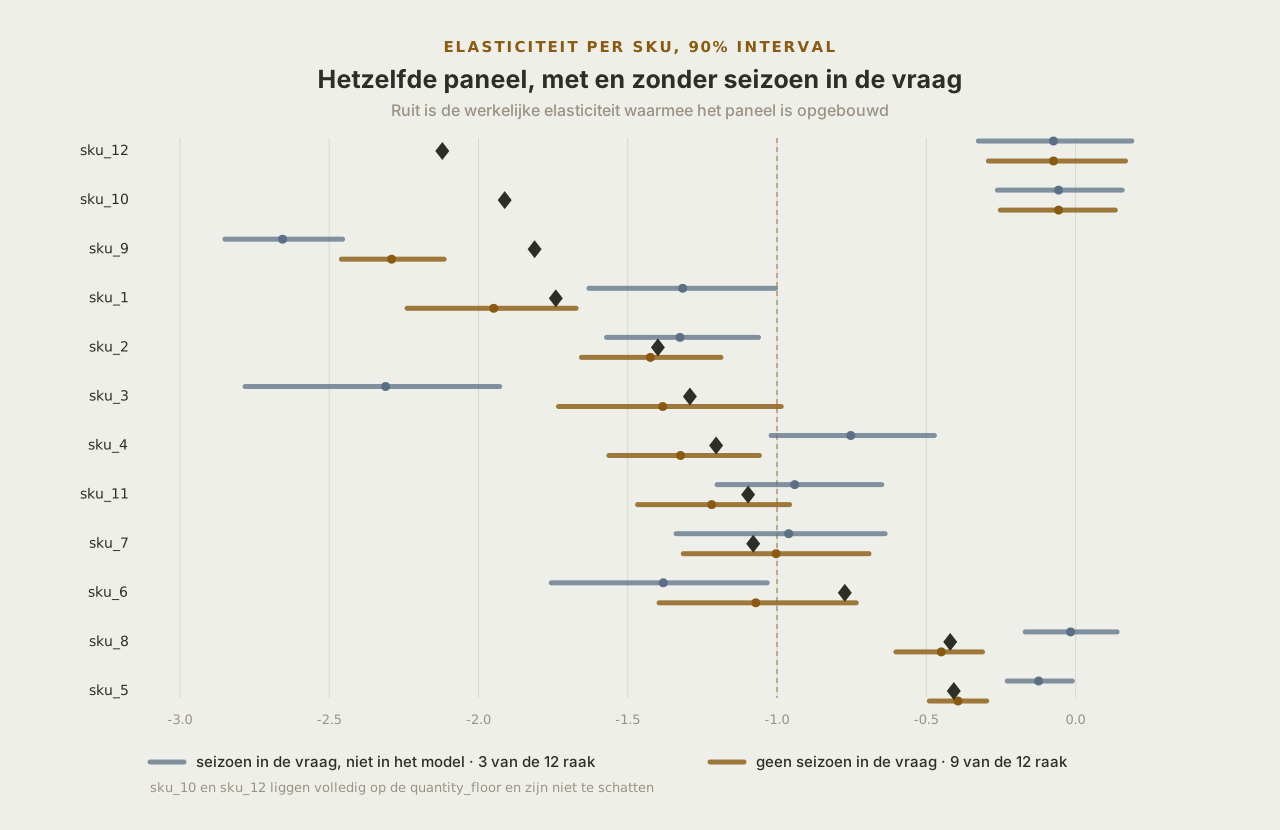
De dekking ging van 3 van de 12 naar 9 van de 12, en de divergenties van 17 naar 3. Sku_5 kwam uit op -0,394 met een band van -0,490 tot -0,298, tegen een werkelijke -0,408. Van een factor drie ernaast naar goed binnen de band, puur door een term die niet in het model zat.
Twee van de drie missers die dan nog overblijven zijn precies de artikelen waar het pakket bij het bouwen al voor waarschuwde. Die waarschuwing is dus geen ruis in je logboek maar een lijst met artikelen waarover je niets mag beweren.
De responscurve zonder top
Voor sku_5 heb ik uit het verstoorde model een prijsraster van 70 tot 130 procent van de laatste prijs voorspeld. Dat is de curve waar je een prijsbesluit op zou baseren.
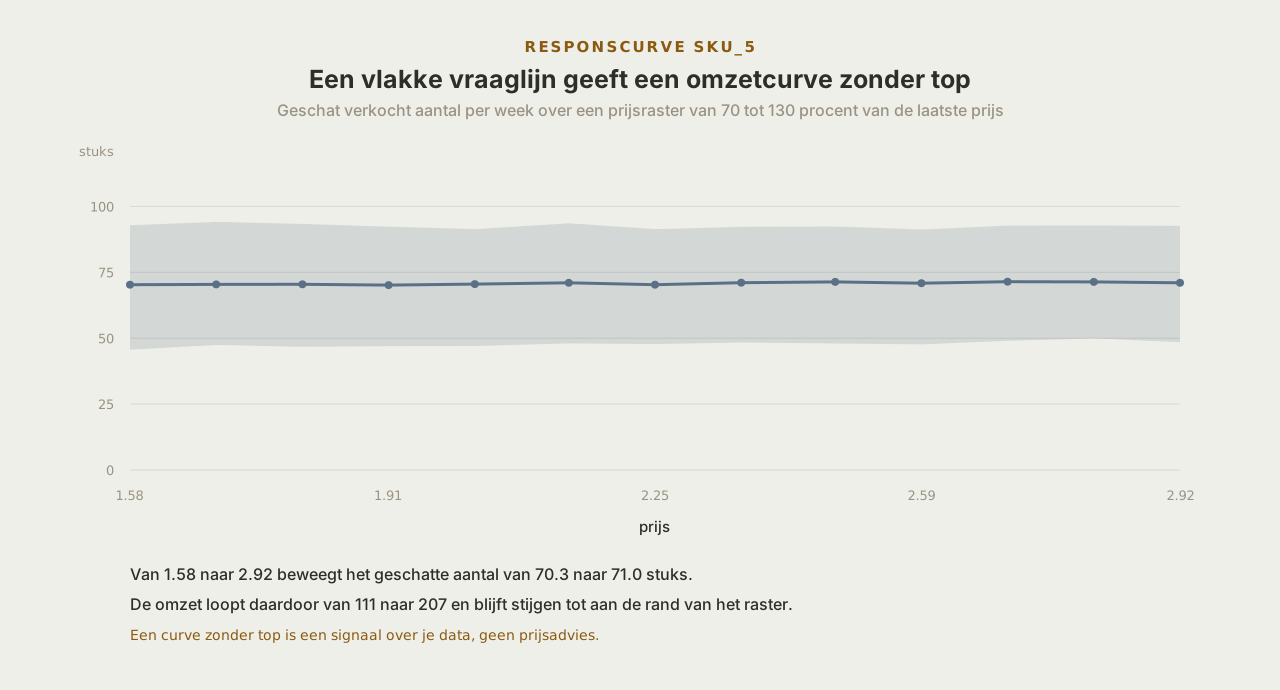
Het geschatte aantal beweegt van 70,3 naar 71,0 stuks over het hele bereik. Omdat het volume vlak blijft, loopt de omzet gewoon mee met de prijs en bereikt hij nergens een top. Als advies gelezen staat er: verhoog tot voorbij de rand van de grafiek.
Dat is niet wat het model bedoelt, maar het is wel wat er in een dashboard terechtkomt als je de curve zonder controle doorzet. Een responscurve zonder top binnen een redelijk prijsbereik is een signaal over je invoer, niet over je prijs.
De grenzen die in de documentatie staan
Twee beperkingen worden netjes benoemd. optimize_prices werkt niet als je kruiselasticiteit aanzet, want dan zijn de artikelen niet meer los van elkaar te optimaliseren; je moet daar zelf scenario’s doorrekenen met predict. En er is geen cold start: een artikel dat niet in de training zat krijgt geen voorspelling, ook niet via zijn categorie.
Voor kruiselasticiteit zelf is de standaardinstelling verstandig. Je kunt alle gerichte paren aanzetten, maar bij een assortiment van enige omvang zijn dat er miljoenen waarvan het overgrote deel niets met elkaar te maken heeft. Met mode="within_group" beperk je het tot paren binnen dezelfde categorie, en daar zit substitutie ook werkelijk.
Wat ik ermee zou doen
Niet als prijsrobot. De keten van een schatting naar een prijs in de winkel loopt via te veel aannames om te automatiseren, en de bovenstaande run laat zien hoe overtuigend een verkeerd antwoord eruitziet.
Wel als sorteerinstrument. De vraag die een assortiment van duizenden artikelen onbeantwoord laat is niet wat de optimale prijs is, maar aan welke artikelen je uberhaupt mag draaien. Een smalle band op een artikel met veel verkopen en echte prijsvariatie is een besluit dat je kunt onderbouwen. Een brede band, of een artikel dat op de vloer ligt, is een opdracht om eerst variatie op te bouwen. Die sortering haal je met dit pakket in een middag uit data die je al hebt.
En de drie controles die niet optioneel zijn: lees de waarschuwingen bij het bouwen, want daar staan de artikelen in waarover je niets mag zeggen. Kijk naar de divergenties voordat je naar de getallen kijkt. En zet elke term die met je vraag meebeweegt, seizoen voorop, als controlevariabele in het model, want anders krijgt de prijs de eer van het seizoen en ziet dat er precies zo betrouwbaar uit als een goede schatting.
Dat laatste kost geen modelkennis. Het kost een kolom.